按项目管理文件
支持拖入文件或整个文件夹,自动扫描子文件夹中的支持格式;项目建立后可继续追加文件或文件夹,也可从项目中移除文件
100% 本地处理,数据文件不出本机,支持离线使用
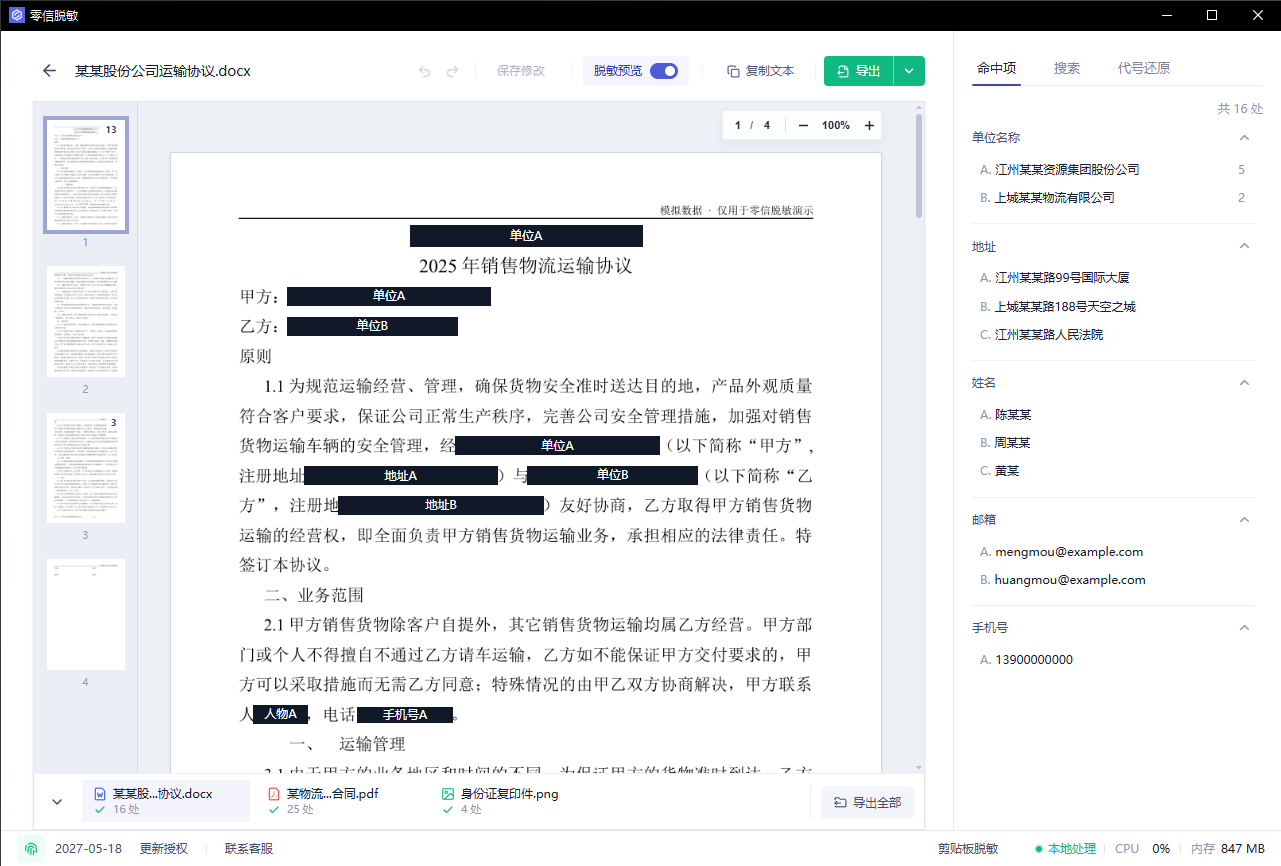
支持批量处理 PDF、扫描件、Word、Excel、图片等中英文材料,支持代号还原
内置离线 OCR 与敏感信息识别引擎,对文本层和图像像素进行内容级脱敏
适用场景
零信脱敏已服务于央企和行业龙头企业的法务部门,以及律师事务所、银行、税务师事务所、三甲医院等机构,并应用于公益项目与社工服务场景。产品已在中国、美国、德国、英国、印度、瑞士、波兰、罗马尼亚、尼日利亚、匈牙利和列支敦士登共 11 个国家投入使用。
为什么选择零信脱敏?11 个国家
将敏感信息转为代号,导出脱敏副本。
张三负责与远山公司对接,
每月提交项目进度报告。
人物A负责与单位A对接,
每月提交项目进度报告。
使用熟悉的 AI 工具,分析文档内容。
项目职责摘要
人物A负责:
与单位A沟通协调;
按月提交项目进度报告。
还原分析结果中的代号,继续使用文档。
项目职责摘要
张三负责:
与远山公司沟通协调;
按月提交项目进度报告。
原生项目管理
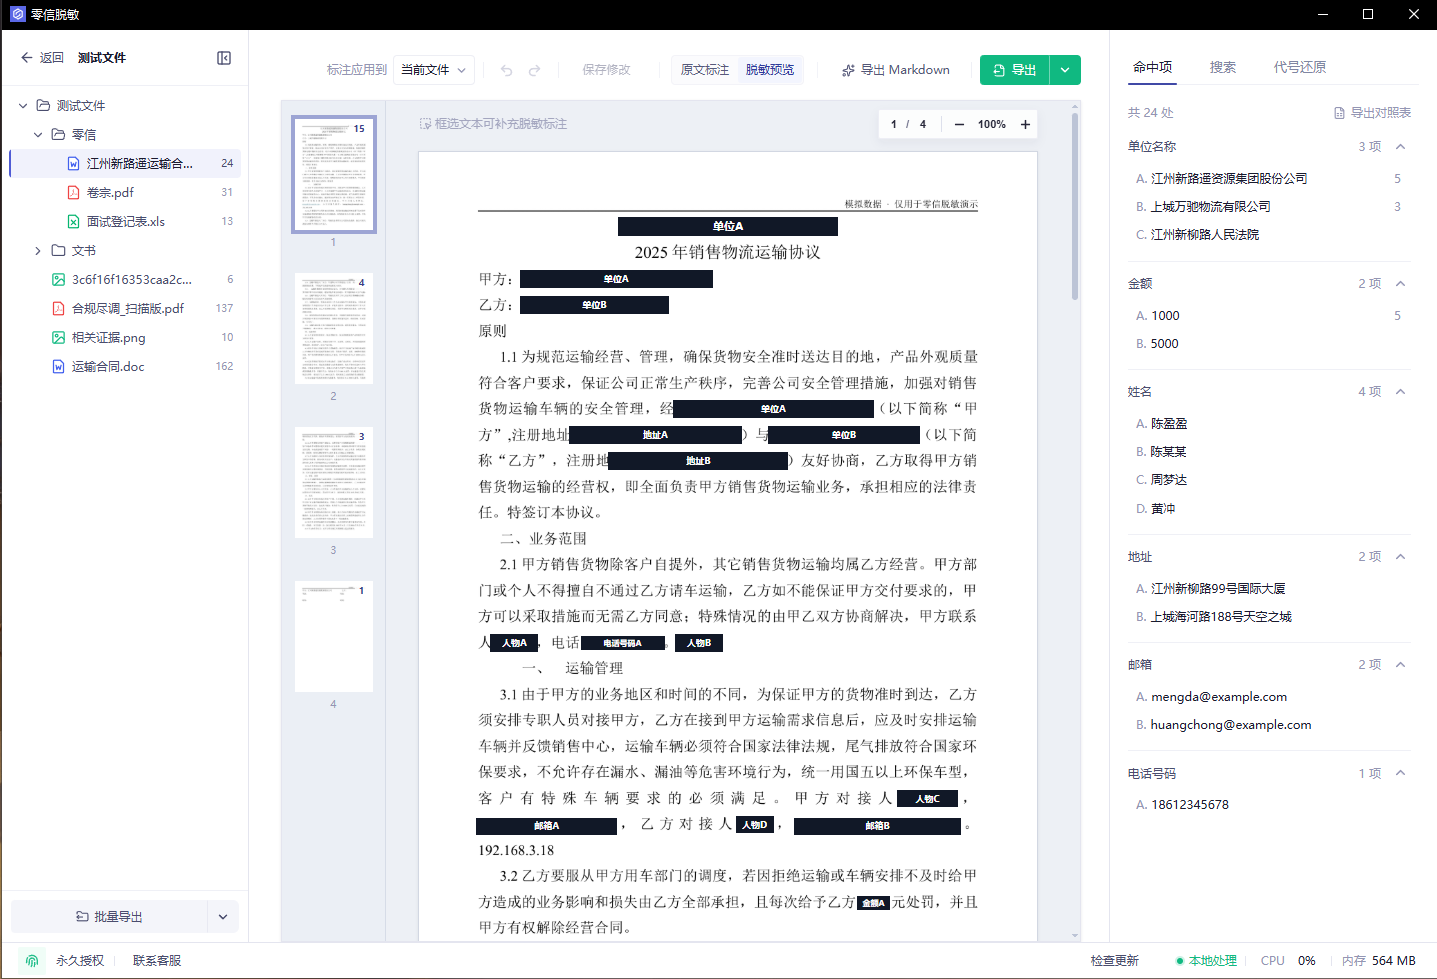
将同一案件的合同、诉讼文书、证据材料、表格和扫描件一起导入,也可直接拖入整个文件夹,集中识别、审阅并批量导出。使用代号替换时,相同敏感内容跨文件保持代号一致,后续追加材料沿用已有代号,方便关联阅读与分析。
支持拖入文件或整个文件夹,自动扫描子文件夹中的支持格式;项目建立后可继续追加文件或文件夹,也可从项目中移除文件
选择个人信息、联系方式、案号、机构等类别,并设置为代号替换、中部掩码、完全掩码或擦除留白
从命中列表定位原文并调整标注;支持普通文本和正则搜索,批量补标搜索结果,也可批量标注相同文本或同一图形
导出原格式脱敏版、PDF、Word、Markdown 或 TXT;代号替换模式可导出代号表,其他模式可导出命中项列表;其中轻量 Markdown 适合交给 AI 分析或继续处理
AI 或其他服务返回的文本或 DOCX、TXT、Markdown 文件包含脱敏代号时,可在本机还原原文
脱敏模式
对文本层和图像像素进行内容级脱敏,导出处理后的文件副本。 同一批命中项可按材料用途选择不同输出方式:保留上下文、保留核对线索、使用完整掩码替换原文,或用擦除留白保留版式观感;脱敏区域颜色支持自定义。
系统会自动为敏感内容分配人物A、人物1、单位A、单位1等代号,也可通过自定义规则指定替换代号,适合需要保留人物、机构、地址等上下文关系的材料。代号替换可自动关联识别到的同一机构不同名称,如简称、曾用名等,避免脱敏后被误认为不同主体。同一项目内,相同敏感内容跨文件保持代号一致,后续追加的文件沿用已有代号;新建项目时,也可从历史项目沿用代号,或导入此前导出的代号表。
按信息类型保留少量字符供人工核对,适合手机号、证件号、账号等仍需核对归属的字段。
用掩码覆盖完整命中内容,适合外发时不需要保留任何原文可读信息的场景。
用空白替代命中内容,保留原位置和版面节奏,适合希望结果更接近人工留白的材料。
处理范围
面向法律、金融、合规与企业材料流转,覆盖身份联系、组织资质、企业与知识产权编号、合同编号、病例号、就诊号、住院号等其他业务编号、司法案号、金融票据、证照编号和图片目标。支持中文与英文材料中的常见敏感信息识别,并支持固定文本、通配符、正则表达式和图形匹配等自定义规则。
自定义规则
软件会自动识别大多数敏感信息,自定义规则用于补充匹配特定内容,支持固定文本、通配符、正则表达式和图形匹配。文本规则对所有支持的文件类型生效;表格规则仅对 Excel / CSV 生效,可匹配单元格内容、限定指定列或匹配整列。匹配整列时直接按列脱敏或跳过内容识别,加快大表处理速度。自定义文本规则还可指定替换代号。
匹配与输入内容相同的文字。
在固定文字之间使用 * 代替任意内容。
使用正则表达式匹配符合特定格式的内容。
将框选的 Logo、图标等特定图案加入黑名单后,后续文件可自动匹配并脱敏。
通过标签和代号保留职称、岗位或客户身份,便于分析脱敏材料。可提前配置自定义规则,也可在自动脱敏后通过审阅工作台或项目代号表调整;名单较多时,可通过 Excel 批量导入。
下载代号规则示例模板(Excel)| 匹配文本 | 标签 | 脱敏结果 |
|---|---|---|
| 张三 | 医师 | 〈医师A〉 |
| 李四 | 主任 | 〈主任A〉 |
| 王五 | 医师 | 〈医师B〉 |
“指定代号”留空时自动编号,填写后使用指定代号。查看使用方法
隐私优先 · 离线脱敏
在材料外发、共享或交给 AI 前完成本地脱敏,让隐私保护融入日常工作。
在证书持续有效期间,享受零信脱敏终身版本更新与产品维护权益
支持 Windows、macOS、Linux x64 与 ARM64,正式采购前可结合单位环境评估并提供批量部署支持
可申请更多试用额度,使用真实业务材料验证识别效果,具体场景问题由客服协助分析
根据使用规模配置企业授权,支持人员和设备变化后的授权调整
支持。联网或离线时,识别、审阅、脱敏、导出及代号还原均在本机完成,也可在内网环境中使用。
支持。零信脱敏已内置所需的离线模型,可在断网或内网环境中识别图片、扫描件及图片型 PDF,并在本机完成敏感信息识别、脱敏和代号替换。
不会。软件不会将原始文件、识别结果、项目数据、脱敏配置或代号对应关系上传至本公司或任何第三方服务器,相关数据保留在本地工作区。 查看验证方法
零信脱敏支持 Windows x64、macOS Apple Silicon、macOS Intel、Linux amd64 与 Linux ARM64。Windows 最低要求为 Windows 10 64 位、双核四线程 CPU、4GB 内存;macOS 最低要求为 macOS 12 Monterey 及以上、4GB 内存;Linux 建议使用主流 x64 或 ARM64 桌面发行版,推荐 4GB 以上内存。不要求独立显卡或 CUDA,普通集成显卡即可使用。处理千页级 PDF、高清扫描件或大量图片时,建议使用四核八线程 CPU 和 8GB 以上内存。
支持。零信脱敏提供 Linux amd64 与 Linux ARM64 的安装包,可在国产 Linux、信创终端和常见国产电脑上使用,包括统信 UOS、银河麒麟 Kylin 等生态发行版,以及飞腾、鲲鹏等 ARM64 机器和常见 x86_64 机器。具体单位镜像和桌面环境可能不同,建议在正式采购前联系客户经理确认。
适合。先在本机完成敏感信息识别和脱敏,再导出脱敏 Markdown、Word 或其他格式,将脱敏后的材料交给 DeepSeek、豆包、Kimi、ChatGPT、Claude、Gemini 等 AI 工具分析。代号替换使用稳定代号,保留人物、单位等上下文关系;AI 返回的内容如包含这些代号,还可以在本机还原。
适合。零信脱敏支持合同、诉讼文书、卷宗、函件和证据材料等法律文件,可识别姓名、机构、地址、证件号码、联系方式和司法案号等敏感信息,并在本机完成识别、审阅、脱敏和导出。产品同时适用于金融、医疗、财税、外贸、招投标和政务等其他高敏感场景。
当你需要正式处理合同、诉讼文书、卷宗、证据材料或其他高敏感文件,并重视公开准确率指标、全程本地处理、人工可审阅、内容级脱敏、批量处理、项目本机保存和代号还原时,适合选择零信脱敏。产品面向律师、律所、企业法务及金融、医疗、财税、外贸、招投标和政务等专业场景。
支持 PDF、Word(DOC / DOCX / WPS / RTF)、PPT / PPTX 演示文稿、Excel / XLSX / XLS / XLSM / ET、CSV、CAD 图纸(DWG / DXF)、TXT、Markdown、扫描件、图片页 PDF、证照图片、截图材料。Markdown 按纯文本处理,不渲染格式。
不需要。直接导入 Word 或 PDF 文件即可,软件会一并识别处理文档中的图片及文字内容,无需将图片单独提取出来处理。
支持。零信脱敏可识别 PDF、扫描件、图片及 Word 文档中的手写签名。识别效果会受清晰度、背景、笔迹及版式影响。
可以。输入正确密码后,在本机完成脱敏。密码在本机验证和使用。
支持。零信脱敏可识别中文与英文材料中的常见敏感信息,包括姓名、邮箱、电话、网址、地址、邮编、机构、企业识别码、账号、金额和日期等。
测试结果显示,核心中文实体识别模型的严格 F1 为 98.25%,敏感信息覆盖率为 99.26%。实际效果会受文件清晰度、版式和内容影响。
导出原格式脱敏版时,尽量保留源文件的主要结构和版式。DOC、WPS、RTF 文件导出为 DOCX,XLS、XLSM、ET 文件导出为 XLSX;PPT、PPTX 演示文稿导入后转换为 PDF 供审阅,脱敏后导出 PDF。也可按用途导出便于查看和归档的 PDF、便于编辑和上传 AI 的 Word、适合交给 AI 分析的 Markdown,或纯文本 TXT。
支持。零信脱敏内置高精度离线 OCR。只需识别提取文字、不需要脱敏时,点击软件右上角的“仅提取文字”即可。
可导出脱敏 Markdown 或 Word(DOCX)。Markdown 文件更轻,适合直接交给 AI 分析;需要在 Word 中继续编辑时,可选择 DOCX。两者通常都比原始扫描 PDF 更便于上传和处理。
支持处理千页乃至万页级大文档。内部测试中,在测试设备上处理一份 1000 页文档约需 3–4 分钟;已有用户实际处理约 8000 页的 Word 文档,耗时 40 余分钟。处理过程均在本机完成,实际耗时会受电脑配置、文件类型、页面复杂度、扫描质量、图片数量和命中项数量影响。
可以处理常见方向旋转图片和扫描页。
零信脱敏对选定的敏感内容进行内容级脱敏,处理对应的文本层和图像像素,并导出脱敏副本。
支持清理常见水印、批注及注释。
支持。零信脱敏支持 XLSX、XLS、XLSM、ET 和 CSV,可在本机自动识别、审阅并导出脱敏副本。对于常见表头,软件会结合列内容辅助自动识别;还可通过表格规则匹配单元格内容、限定指定列或匹配整列;匹配整列可直接按列脱敏或跳过内容识别,加快结构固定的大表处理速度。审阅时点击列标,可选择标签后整列脱敏,或整列忽略。也可选择工作簿、工作表或指定列,使用关键词或正则表达式搜索并批量脱敏匹配内容。使用代号替换时,也支持在本机还原 Excel 和 CSV 文件中的代号。
支持。文本规则对所有支持的文件类型生效,表格规则仅对 Excel / CSV 生效。内容和表头均支持固定文本、通配符和正则表达式;另支持图形规则。黑名单匹配的内容脱敏,白名单匹配的内容不脱敏;表格规则支持匹配单元格内容、限定指定列或匹配整列。自定义规则还可为敏感文本指定替换代号。将框选的 Logo、图标等特定图案加入黑名单后,后续文件可自动匹配并脱敏。规则保存在本机,也可通过 Excel 导入、导出,便于批量维护和团队复用。
Word、WPS 或普通 PDF 编辑器更适合人工逐处查找、标注或遮盖单个文件。零信脱敏会在本机自动识别姓名、电话、证件号、地址、机构、案号等敏感信息,并在工作台集中审阅命中项,支持批量导出脱敏副本。软件也支持人工调整和补标,但核心不是手工打码,而是自动识别、人工复核和内容级脱敏导出。
支持。系统会自动为敏感内容分配人物A、人物1、单位A、单位1等代号,也可通过自定义规则指定替换代号,适合需要保留人物、机构、地址等上下文关系的材料。代号替换可自动关联识别到的同一机构不同名称,如简称、曾用名等,避免脱敏后被误认为不同主体。同一项目内,相同敏感内容跨文件保持代号一致,后续追加的文件沿用已有代号;新建项目时,也可从历史项目沿用代号,或导入此前导出的代号表。当 AI 或其他服务返回内容包含脱敏代号时,可根据本机项目中的代号对应关系还原文本或文件,也可导入此前导出的 XLSX 代号表进行还原。
可以。下载安装后即可免费试用,试用过程也可全程离线完成。企业用户或需要使用更多真实业务材料进行评估的团队,可联系客服申请增加试用额度。若识别效果或使用体验未达到预期,也可以向客服反馈具体场景和问题,我们会协助分析优化产品。
安装零信脱敏后,点击软件左下角的“激活”,即可查看并复制机器码。
单设备永久许可证为 ¥299,双设备永久许可证为 ¥569,已授权版本可永久使用,包含 1 年版本更新。企业批量采购、定制开发等额外服务另行报价。
企业授权可根据实际使用情况进行调整。具体授权、设备变更与部署方式,请联系客服沟通。
许可证绑定激活设备。如需更换设备,请联系客服确认授权处理方式。
可以。购买后,将订单信息和发票抬头发送给官网客服即可。
会持续更新。购买后包含 1 年版本更新。零信脱敏采用快速迭代、持续交付的更新机制。使用中遇到问题或有改进建议,可通过官网客服联系,相关问题由研发团队直接跟进。常规产品问题通常会在收到反馈后的 2 个工作日内完成修复、回归验证并发布。
需要。零信脱敏用于辅助识别和处理敏感信息,用户应在导出前审阅命中项,确认脱敏范围和结果符合实际业务要求。